Om Simbas chaufförer


Anslut dataverktyg med ODBC- och JDBC-drivrutiner
Använd drivrutiner av produktionsklass för att hämta realtidsdata från SaaS, NoSQL, big data, ERP och applikationer via de verktyg som dina team redan använder.
Problemet
Verktyg kräver verkliga kopplingar
Företagsdata finns i SaaS-, ERP-, NoSQL- och molnbaserade källor samt i big data-källor som verktygen inte hanterar särskilt bra. När anslutningen saknas avstannar arbetet redan innan analysen hinner påbörjas.
Kom åt uppgifterna
Team väljer sällan var data lagras: SaaS, ERP, NoSQL, molnet, big data eller anpassade källor som ett verktyg inte har bra stöd för. När anslutningen saknas eller är opålitlig avstannar arbetet redan innan analysen hinner börja. Det första problemet är en pålitlig anslutning.
Behåll data på plats
Att flytta data till en annan pipeline eller kopiera dem medför fördröjningar, kostnader, frågor kring styrning samt ytterligare ett system att underhålla. Många team behöver bara befintliga verktyg för att hämta realtidsdata via standarder som de redan känner till. Undvik att flytta data när en drivrutin kan sköta uppgiften.
”Survive”-produktionen
En anslutning som fungerar vid ett test kan sluta fungera i praktiken: API-förändringar, särdrag i metadata, autentisering och omfattande sökningar. Anslutningen i produktionsmiljön kräver mer än bara en enkel koppling. Den måste hålla när verksamheten är beroende av den.
Så här fungerar det
Koppla samman de verktyg som teamen redan använder
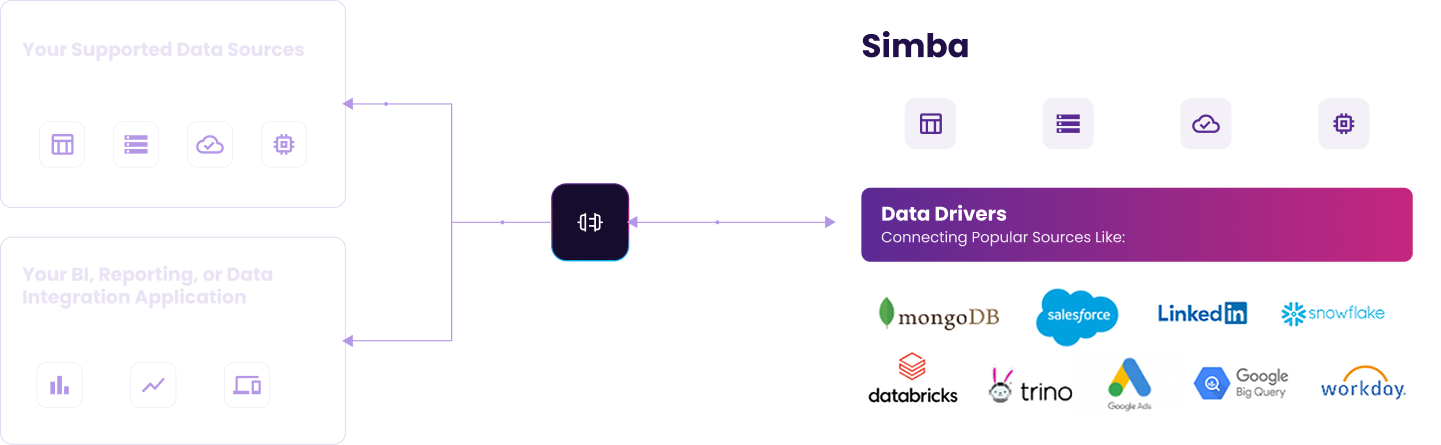
Simba Data Connectivity ger teamen standardbaserad ODBC- och JDBC-åtkomst till realtidsdata inom analys, BI, ETL, rapportering och applikationsarbetsflöden. Anslut befintliga verktyg via drivrutiner som är redo för produktionsmiljö och utvecklade för just den källa du behöver.
ODBC- och JDBC-drivrutiner
Koppla samman analysverktyg, BI, ETL, rapportering och arbetsflöden för anpassade appar genom standarder som dina verktyg redan stöder.
Tillgång till realtidsdata
Fråga av källdata direkt utan att skapa en separat kopia enbart för att göra den tillgänglig för ett verktyg.
Källspecifikt djup
Använd drivrutiner som är utformade utifrån beteendet, metadatan, autentiseringen och sökmönstren för varje källa.
Klar för produktion
Stöd för företagsarbetsbelastningar där tillförlitlighet, uppdateringsbeteende, autentisering och prestanda är avgörande.
Verktygsanpassad integration
Ge teamen ett enhetligt sätt att koppla samman de applikationer de använder med de källor de behöver.
Drivrutinskatalog
Börja med drivrutinskatalogen för att hitta ODBC- eller JDBC-anslutningsvägen för din källa.
VARFÖR VÅRT FÖRETAG
Utvecklad för de verktyg du litar på
Använd de ODBC- och JDBC-standarder som dina verktyg redan stöder, undvik onödiga kopieringar i dataströmmen och hitta snabbt rätt drivrutin i katalogen.
Standardbaserad åtkomst
Mindre utbredning av rörledningar
Hitta rätt förare snabbare
Hur ska du koppla ihop uppgifterna?
| Funktion | Exportera och importera på nytt | Anpassad API-kod | ETL-process | Simba Driver |
|---|---|---|---|---|
| Fråga live-data direkt på plats | ||||
| Ingen extra kopia att underhålla | ||||
| Fungerar med befintliga verktyg | ||||
| Källmetadata och autentisering | ||||
| Fungerar även när källorna ändras | ||||
| Snabb väg till en känd källa | ||||
| Omvandla eller omforma data | ||||
| Kombinera flera källor |